shuatigo
只考虑主考点
计算机408

2014计算机408全卷预览

2014年计算机408真题

2014年计算机408真题完整试卷,包含 40 道选择题、0 道填空题和 7 道解答题,共 47 题,题目分值合计 150 分。可按目录阅读全卷,展开参考答案解析,或进入对应题目练习。

返回年度练习
47题全卷题目
150分题目分值合计
40题选择题 · 80分
0题填空题 · 0分
7题解答题 · 70分

选择题

40 题 · 共 80 分

第 1 题

数据结构
2 分

下列程序段的时间复杂度是()。

c 复制代码
count = 0;
for (k = 1; k <= n; k *= 2)
    for (j = 1; j <= n; ++j)
        ++count;

A. O(log⁡2n)O(\log_2 n)

B. O(n)O(n)

C. O(nlog⁡2n)O(n\log_2n)

D. O(n2)O(n^{2})

查看答案与解析收起答案与解析

参考答案:C

答案:C。

计算嵌套循环时,应先分别数执行次数,再考虑内循环是否随外层变量变化。外层 k 从 1 开始依次为 1、2、4、8……,第 t 次的值为 2t−12^{t-1},满足 2t−1≤n2^{t-1}\le n,所以共执行 ⌊log⁡2n⌋+1\lfloor\log_2 n\rfloor+1 次。

每次内层 j 都从 1 到 n,与 k 无关,因此每轮恰执行 n 次 ++count。总次数为 n(⌊log⁡2n⌋+1)n(\lfloor\log_2n\rfloor+1),时间 O(nlog⁡2n)O(n\log_2n),选 C。A 只算外层,B 只算一轮内层,D 把外层误认为线性增长。k*=2 与 k++ 的循环次数有本质区别;题目按通常复杂度模型忽略整数溢出。
进入练习

第 2 题

数据结构
2 分

假设栈初始为空,将中缀表达式 a/b+(c∗d−e∗f)/ga / b + (c^{*}d - e^{*}f) / g 转换为等价的后缀表达式的过程中,当扫描到 ff 时,栈中的元素依次是()。

A. +(∗−+\left(* - \right.

B. +(−∗+(-^{*}

C. /+(∗−∗)/ + (* - *)

D. / + - *

查看答案与解析收起答案与解析

参考答案:B

答案:B。

中缀转后缀用运算符栈:操作数直接输出;扫描新运算符时,先弹出栈顶优先级不低于它的运算符,左括号阻止继续弹出;右括号到来才弹出括号内符号。

扫描 a/b 后栈为 /,遇 + 时先弹出 /,栈变为 +;遇 ( 压入,遇 c*d 的 * 再压入。遇 - 时,先弹出前面的 ,再压入 -,所以栈为 +、(、-。随后 e 直接输出,第二个 * 优先级高于 -,压入;f 也直接输出,不改变栈。故自底向上为 +、(、-、,选 B。A 颠倒减号与乘号,C 保留了已弹出的 / 和尚未扫描的右括号,D 丢左括号且错保留 /。

进入练习

第 3 题

数据结构
2 分

循环队列放在一维数组 A[0...M-1]中,end1 指向队头元素,end2 指向队尾元素的后一个位置。假设队列两端均可进行入队和出队操作,队列中最多能容纳 M-1 个元素。初始时为空。下列判断队空和队满的条件中,正确的是()。

A. 队空: end1 == end2;

队满:end1 == (end2 + 1) mod M

B. 队空: end1 == end2;

队满:end2==(end1+1) mod(M-1)

C. 队空: end2 == (end1 + 1) mod M;

队满:end1 == (end2 + 1) mod M

D. 队空: end1 == (end2 + 1) mod M;

队满:end2 == (end1 + 1) mod (M - 1)

查看答案与解析收起答案与解析

参考答案:A

答案:A。

end1 指向队头,end2 指向队尾后的空位置,元素占据从 end1 到 end2 前一格的环形区间,数量为 (end2−end1+M) mod M(end2-end1+M)\bmod M。数量为 0 时两指针相等,所以队空条件为 end1==end2。

数组有 M 格却最多放 M-1 个元素,是保留一格以区分空、满。满时尾后指针再前进一格就到队头,即 (end2+1) mod M=end1(end2+1)\bmod M=end1,选 A。B 用 mod(M-1),混淆容量与数组长度;C 把相邻指针误判为空;D 同时错误。双端均能操作会改变指针更新方向,但不改变元素计数关系及空满条件。所有环绕运算均以实际数组长度 M 取模。

进入练习

第 4 题

数据结构
2 分

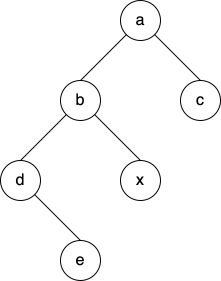
若对如下的二叉树进行中序线索化,则结点 xx 的左、右线索指向的结点分别是( )。

第 4 题图 1

A. e,ce, c

B. e,ae, a

C. d,cd, c

D. b,ab, a

查看答案与解析收起答案与解析

参考答案:D

答案:D。

中序遍历为“左子树、根、右子树”,中序线索利用空孩子指针保存前驱和后继。图中根为 a,左孩子 b、右孩子 c;b 的左孩子 d、右孩子 x;d 有右孩子 e。先遍历 d 的子树得 d、e,再访问 b、x,最后访问 a、c,完整中序序列为 d、e、b、x、a、c。

x 没有左右孩子,可以设置两条线索;它前面紧邻 b,后面紧邻 a,所以左线索指 b、右线索指 a,D 正确。A、B 把前驱误选为 e,忽略中间的 b;C 把前驱选 d 且后继选 c,两边都越过了紧邻结点。线索应指序列中的直接前驱、后继,不能只看图上相邻位置或父子关系。

进入练习

第 5 题

数据结构
2 分

将森林 FF 转换为对应的二叉树 TT , FF 中叶结点的个数等于( )。

A. TT 中叶结点的个数

B. TT 中度为1的结点个数

C. TT 中左孩子指针为空的结点个数

D. TT 中右孩子指针为空的结点个数

查看答案与解析收起答案与解析

参考答案:C

答案:C。

森林转换成二叉树采用“左孩子、右兄弟”表示:二叉树结点的左指针指向原树的第一个孩子,右指针指向原树的下一个兄弟;森林各树的根也按兄弟关系连接。

原森林的叶结点定义为没有任何孩子,恰对应二叉树中左孩子指针为空,故 C 正确。A 错,因为森林叶仍可能有兄弟,在二叉树里有右孩子,并非二叉树叶。B 错,因为度为 1 的结点可能仅有左孩子,对应原森林非叶;森林最后一个无兄弟叶又可能度为 0。D 的右指针为空仅表示没有下一个兄弟,与是否有孩子无关。转换保持结点集合,但改变了孩子与兄弟所占的指针含义。

进入练习

第 6 题

数据结构
2 分

5个字符有如下4种编码方案,不是前缀编码的是()。

A. 01,0000,0001,001,1

B. 011,000,001,010,1

C. 000,001,010,011,100

D. 0, 100, 110, 1110, 1100

查看答案与解析收起答案与解析

参考答案:D

答案:D。

前缀编码要求任意码字都不是另一个码字的开头部分,这样扫描位串时才能在读到完整码字后立刻确定一个字符,不必向后看。判断时要检查长短码字的前缀关系,而不只是检查码字是否重复。

A 中 1 与其他以 0 开头的码分离;01、001、0000、0001 各自在不同分支,没有互为前缀。B 中四个 3 位码互不相同,单独的 1 也不在它们开头。C 全是互异的 3 位码,同长度码不可能互为真前缀。D 的 110 是 1100 的前缀,读到 110 时无法判断已结束还是还需读 0,因此 D 不是前缀码。0 不是 100 等码的前缀,因为必须从第一位开始比较。

进入练习

第 7 题

数据结构
2 分

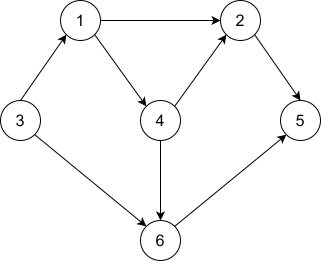
对如下所示的有向图进行拓扑排序,得到的拓扑序列可能是()。

A. 3, 1, 2, 4, 5, 6

B. 3, 1, 2, 4, 6, 5

C. 3, 1, 4, 2, 5, 6

D. 3, 1, 4, 2, 6, 5

第 7 题图 1
查看答案与解析收起答案与解析

参考答案:D

答案:D。

拓扑序要求每条有向边 u→v 的起点 u 均排在终点 v 前面。图中约束是 3→1、3→6、1→2、1→4、4→2、4→6、2→5、6→5。逐次删除入度为 0 的顶点:开始只有 3,随后只有 1,再只有 4;删掉 4 后,2、6 均可选,最后才是 5。

A 的 2 出现在 4 前,违反 4→2,且 5 在 6 前,违反 6→5;B 仍违反 4→2;C 虽满足 4 在 2 前,却把 5 放在 6 前。D 的 3、1、4、2、6、5 满足全部边约束,故可行。2 与 6 的先后可交换,不意味着其他依赖关系也能交换;拓扑排序检查的是边方向,不是顶点数字大小。

进入练习

第 8 题

数据结构
2 分

用哈希(散列)方法处理冲突(碰撞)时可能出现堆积(聚集)现象。下列选项中,会受堆

积现象直接影响的是()。

A. 存储效率

B. 散列函数

C. 装填(装载)因子

D. 平均查找长度

查看答案与解析收起答案与解析

参考答案:D

答案:D。

散列冲突后用开放定址等方法找空位置,可能形成连续占用的区域,称为堆积或聚集。新的关键字落入该区域时,要探测更多位置;查找已有关键字或确认不存在的关键字也可能走更长的探测序列,因此直接受到影响的是比较或探测的平均次数,即 D 平均查找长度。

A 存储效率主要取决于空间组织和占用情况,聚集的直接后果是查找变慢;B 散列函数本身已确定,聚集不会改变它的表达式;C 装填因子 α=n/m\alpha=n/m 只由记录数 n 与表容量 m 决定,同一装填因子下也可能有不同程度的聚集。所以不能把“元素集中在一段”误认为记录数或容量发生了改变。

进入练习

第 9 题

数据结构
2 分

在一棵具有 15 个关键字的 4 阶 B 树中, 含关键字的结点个数最多是 ( )。

A. 5

B. 6

C. 10

D. 15

查看答案与解析收起答案与解析

参考答案:D

答案:D。

求结点数最大,应让每结点尽量少存关键字。4 阶 B 树非根结点至少含 ⌈4/2⌉−1=1\lceil4/2\rceil-1=1 个关键字;非空根也至少含 1 个。因此 15 个关键字最多对应 15 个含关键字的结点,超过 15 必然出现空结点。

这个上限可以达到:构造四层满二叉形状,各层结点数为 1、2、4、8,共 15;每结点放 1 个关键字,每个非叶结点有 2 个孩子,符合4阶树的下限和上限,叶均在同一层。按中序给结点安排递增关键字即可满足搜索关系。故 D 正确。A 的 5 偏向每结点多装关键字,B、C 都小于可达到的 15,不能回答“最多”。

进入练习

第 10 题

数据结构
2 分

用希尔排序方法对一个数据序列进行排序时,若第1趟排序结果为9,1,4,13,7,8,20,23,15,则该趟排序采用的增量(间隔)可能是()。

A. 2

B. 3

C. 4

D. 5

查看答案与解析收起答案与解析

参考答案:B

答案:B。

希尔排序一趟使用增量 d,将下标相差 d 的元素分成一组,在各组内部做插入排序。因此完成这一趟后,每条间隔为 d 的子序列必须有序,但整个序列未必有序。可直接检验结果,无需猜原序列。

若 d=3,三组为 (9,13,20)、(1,7,23)、(4,8,15),都递增,故 B 可能。若 d=2,第一组 (9,4,7,20,15) 中 9>4,A 不可能;若 d=4,第一组 (9,7,15) 中 9>7,C 不可能;若 d=5,第一组 (9,8) 中 9>8,D 不可能。检查时按原位置每隔 d 取数,不是把相邻 d 个数作为一组,也不是要求全序列已经升序。

进入练习

第 11 题

数据结构
2 分

下列选项中,不可能是快速排序第2趟排序结果的是()。

A. 2,3,5,4,6,7,92, 3, 5, 4, 6, 7, 9

B. 2,7,5,6,4,3,9

C. 3,2,5,4,7,6,9

D. 4, 2, 3, 5, 7, 6, 9

查看答案与解析收起答案与解析

参考答案:C

答案:C。

快速排序每次划分至少让一个枢轴到最终位置,且其左侧均小于它、右侧均大于它。第二趟继续对非平凡子区间划分,除了第一趟枢轴,应有更多枢轴满足这一分隔关系。检查不能只看某数是否偶然落在排序后的下标上。

A 可先以 6 划分,第二趟左区间以 2、右区间以 7 划分,得到该分隔结构;B 可先以 2 划分,再在右区间以 9 划分;D 可先以 9 划分,再在左区间以 5 划分。C 中只有末尾 9 符合分隔关系:2、3 互相逆序,4、5 互相逆序,6、7 互相逆序,任何一个都不能是第二趟新增的已确定枢轴。因此 C 不可能。子区间内部仍可无序,不能把“未全排好”误作错误依据。

进入练习

第 12 题

计算机组成原理
2 分

程序 P 在机器 M 上的执行时间是 20s,编译优化后,P 执行的指令数减少到原来的 70%,而 CPI 增加到原来的 1.2 倍,则 P 在 M 上的执行时间是()。

A. 8.4 s8.4 \mathrm{~s}

B. 11.7s

C. 14.0 s14.0 \mathrm{~s}

D. 16.8 s16.8 \mathrm{~s}

查看答案与解析收起答案与解析

参考答案:D

答案:D。

程序 CPU 时间满足 T=I×CPI/fT=I\times CPI/f,I 为指令数,f 为主频。编译优化没有更换机器,主频不变;新指令数是原来的 0.7 倍,新 CPI 却是原来的 1.2 倍,说明每条指令平均耗费的周期变多。两种变化需相乘,而不是相加或只取其中一项。

时间比例 T′/T=0.7×1.2=0.84T'/T=0.7\times1.2=0.84,所以 T′=20×0.84=16.8 sT'=20\times0.84=16.8\,\mathrm s,选 D,优化后的总周期数减少 16%。C 的 14 s 只计指令数减少,漏 CPI 增加;B 约 11.7 s 是误用 20×0.7/1.220\times0.7/1.2;A 的 8.4 s 也不符合两个给定比例。优化效果要看总周期数,不能只凭指令数下降判断具体加速比。

进入练习

第 13 题

计算机组成原理
2 分

若 x=103,y=−25x = 103, y = -25 ,则下列表达式采用8位定点补码运算实现时,会发生溢出的是()。

A. x+yx + y

B. −x+y-x + y

C. x−yx - y

D. −x−y-x - y

查看答案与解析收起答案与解析

参考答案:C

答案:C。

8 位定点补码能表示 [−27,27−1]=[−128,127][-2^7,2^7-1]=[-128,127],负端比正端多一个值。判断溢出最直接的方法是先算数学真值,再与该范围比较,不能只凭最高位有进位就判断。

代入 x=103、y=-25:A 为 x+y=103−25=78x+y=103-25=78,在范围内;B 为 −x+y=−103−25=−128-x+y=-103-25=-128,恰好是最小值,仍不溢出;C 为 x−y=103+25=128x-y=103+25=128,超过最大值 127,溢出;D 为 −x−y=−103+25=−78-x-y=-103+25=-78,也在范围内。因此选 C。若把 -128 误排除,就会误选 B;补码加法中同号相加且结果符号改变是溢出特征,C 转成加法后两个正数之和会出现这一现象。

进入练习

第 14 题

计算机组成原理
2 分

float 型数据常用 IEEE 754 单精度浮点格式表示。假设两个 float 型变量 x 和 y 分别存放在 32 位寄存器 f1 和 f2 中,若 (f1)=CC90 0000H(f1)=CC90\ 0000H , (f2)=B0C0 0000H(f2)=B0C0\ 0000H ,则 x 和 y 之间的关系为()。

A. x<yx < y 且符号相同

B. x<yx < y 且符号不同

C. x>yx > y 且符号相同

D. x>yx > y 且符号不同

查看答案与解析收起答案与解析

参考答案:A

答案:A。

单精度浮点位串按“1 位符号、8 位阶码、23 位小数”拆分。CC900000H 与 B0C00000H 的最高位都为 1,所以 x、y 都是负数,可先排除符号不同的 B、D。

x 的阶码是 100110012=15310011001_2=153,真实指数 153−127=26153-127=26,有效数为 1.125;y 的阶码是 011000012=9701100001_2=97,真实指数 97−127=−3097-127=-30,有效数为 1.5。因此 x=−1.125×226x=-1.125\times2^{26},y=−1.5×2−30y=-1.5\times2^{-30},x 的绝对值远大于 y。负数绝对值越大,数值越小,故 x<y 且同号,A 正确、C 错误。不能像正整数那样按整个位串的无符号大小直接判浮点数大小。

进入练习

第 15 题

计算机组成原理
2 分

某容量为 256MB 的存储器由若干 4M×8 位的 DRAM 芯片构成,该 DRAM 芯片的地址引脚和数据引脚总数是()。

A. 19

B. 22

C. 30

D. 36

查看答案与解析收起答案与解析

参考答案:A

答案:A。

4M×8 位表示一片芯片有 4×220=2224\times2^{20}=2^{22} 个可寻址单元,每单元 8 bit。完整单元地址需要 22 位,但 DRAM 采用行、列地址复用:先在同一组地址引脚上送 11 位行地址,再送 11 位列地址,因此物理地址引脚只需 11 根。

每个单元读写 8 位数据,需要 8 根数据引脚,总数 11+8=1911+8=19,选 A。B 的 22 仅是未复用的地址位数,C 的 30 将 22 个逻辑地址位全当物理引脚再加数据,D 也不符合芯片组织。256 MB 决定要用多少片芯片,不改变单片芯片引脚数;题目仅统计地址与数据,不计电源、读写控制、行列选通信号等其他引脚。

进入练习

第 16 题

计算机组成原理
2 分

采用指令 Cache 与数据 Cache 分离的主要目的是()。

A. 降低 Cache 的缺失损失

B. 提高 Cache 的命中率

C. 降低 CPU 平均访存时间

D. 减少指令流水线资源冲突

查看答案与解析收起答案与解析

参考答案:D

答案:D。

流水线同一时刻有多条指令处于不同阶段,例如一条在 IF 取指,另一条在 MEM 读取或写入数据。若只有一个 Cache 访问通路,二者可能竞争同一硬件端口,造成结构冒险,必须暂停其中一条。

指令 Cache 与数据 Cache 分离后,两阶段可分别访问自己的 Cache,减少这种资源冲突,故 D 是主要目的。A 的缺失损失取决于块调入等处理,不由分离本身保证下降;B 命中率可能因容量划分、访问特性改变,但不一定提高;C 平均访存时间可能间接受益,却不是该结构针对的首要流水线问题。应区分数据相关、控制冒险与结构资源冲突,此处解决的是第三类。

进入练习

第 17 题

计算机组成原理
2 分

某计算机有 16 个通用寄存器,采用 32 位定长指令字,操作码字段(含寻址方式位)为 8 位,Store 指令的源操作数和目的操作数分别采用寄存器直接寻址和基址寻址方式。若基址寄存器可用任一通用寄存器,且偏移量用补码表示,则 Store 指令中偏移量的取值范围是()。

A. −32768∼+32767-32768 \sim +32767

B. −32767∼+32768-32767\sim +32768

C. −65536∼+65535-65536 \sim +65535

D. −65535∼+65536-65535 \sim +65536

查看答案与解析收起答案与解析

参考答案:A

答案:A。

Store 要说明把哪个寄存器的数据存到哪个内存地址。源操作数为寄存器直接寻址,需要一个源寄存器编号;目的地址采用基址寻址,需要一个基址寄存器编号与偏移。16 个通用寄存器均可使用,每个编号需 log⁡216=4\log_2 16=4 位。

32 位指令中操作码及寻址方式已占 8 位,两个寄存器编号再占 8 位,剩余偏移字段为 32−8−4−4=1632-8-4-4=16 位。16 位补码范围 [−215,215−1]=[−32768,32767][-2^{15},2^{15}-1]=[-32768,32767],选 A。B 颠倒补码两端的不对称性;C、D 的范围需要 17 位,超出实际字段。既然寻址方式位已包含在 8 位里,不能再重复扣除。

进入练习

第 18 题

计算机组成原理
2 分

某计算机采用微程序控制器,共有 32 条指令,公共的取指令微程序包含 2 条微指令,各指令对应的微程序平均由 4 条微指令组成,采用断定法(下地址字段法)确定下条微指令地址,则微指令中下地址字段的位数至少是()。

A. 5

B. 6

C. 8

D. 9

查看答案与解析收起答案与解析

参考答案:C

答案:C。

微指令存放在控制存储器中,下地址字段需要能指出下一条微指令所在的控制存储单元。它编码的是微指令地址,不能只按机器指令种类数来算。

32 条机器指令各有平均 4 条微指令,共 32×4=12832\times4=128 条;公共取指微程序的 2 条只存一份,再加上得到 130 个控制存储单元。7 位只能寻址 27=1282^7=128 单元,不够;8 位可寻址 256 单元,足够,所以最少 8 位,选 C。A 的 5 位只够区分 32 条机器指令,B 的 6 位只覆盖 64 个单元,D 的 9 位虽可用但不是最少。公共微程序既不能漏掉,也不能给每条指令重复加 2 条。

进入练习

第 19 题

计算机组成原理
2 分

某同步总线采用数据线和地址线复用方式, 其中地址/数据线有 32 根, 总线时钟频率为 66MHz66 \mathrm{MHz} , 每个时钟周期传送两次数据 (上升沿和下降沿各传送一次数据), 该总线的最大数据传输率 (总线带宽) 是 ( )。

A. 132 MB/s132 \mathrm{~MB} / \mathrm{s}

B. 264MB/s264\mathrm{MB / s}

C. 528MB/s528\mathrm{MB / s}

D. 1056MB/s1056\mathrm{MB / s}

查看答案与解析收起答案与解析

参考答案:C

答案:C。

总线带宽是单位时间最多传送的数据量。地址/数据复用线为 32 根,数据传输阶段一次可传 32 bit=4 B;每个时钟的上升沿、下降沿都传送,共 2 次,因此每周期最多传 8 B。

频率为 66×10666\times10^6 周期/秒,峰值数据率 4×2×66×106=528×106 B/s=528 MB/s4\times2\times66\times10^6=528\times10^6\,\mathrm{B/s}=528\,\mathrm{MB/s},选 C。A 少算线宽或传送次数,B 只算每周期一次,D 又多乘一次 2。地址阶段会降低实际有效吞吐,但题目问最大数据传输率,不给事务内地址开销比例,不能因地址数据复用就擅自把峰值折半。bit 与 byte 应先换算。

进入练习

第 20 题

计算机组成原理
2 分

一次总线事务中,主设备只需给出一个首地址,从设备就能从首地址开始的若干连续单元读出或写入多个数据。这种总线事务方式称为()。

A. 并行传输

B. 串行传输

C. 突发传输

D. 同步传输

查看答案与解析收起答案与解析

参考答案:C

答案:C。

突发传输的特点是一次总线事务只发送首地址及相应控制信息,随后按连续地址传送多个数据,从设备可以自行递增地址。这样不用为每个字都重新发送地址,特别适合 Cache 块填充等连续数据传送,故 C 正确。

A 并行传输描述多位数据是否同时使用多根线路;B 串行传输描述数据位是否顺序使用一条或少量线路;D 同步传输描述是否由统一时钟协调。它们与“一首地址后连续多次数据”属于不同分类维度,均不是本题定义。突发事务可以在同步总线上进行,也可以使用并行数据线,但题意的识别特征是连续数据共享一次地址阶段,不能只看到多个数据就选并行。

进入练习

第 21 题

计算机组成原理
2 分

下列有关 I/O 接口的叙述中,错误的是()。

A. 状态端口和控制端口可以合用同一个寄存器

B. I/O 接口中 CPU 可访问的寄存器称为 I/O 端口

C. 采用独立编址方式时,I/O 端口地址和主存地址可能相同

D. 采用统一编址方式时,CPU不能用访存指令访问I/O端口

查看答案与解析收起答案与解析

参考答案:D

答案:D。

CPU 可访问的接口寄存器叫 I/O 端口,有数据、状态、控制等类型。A 正确:状态常由 CPU 读、控制常由 CPU 写,硬件可让二者共用一个地址或寄存器资源,按读写方向区分。B 正确,是 I/O 端口的定义。C 正确:独立编址使用单独的 I/O 地址空间,即使端口与主存地址数值相同,也由不同指令或控制信号区分。

D 错:统一编址把端口映射到存储器地址空间,CPU 正是用普通访存指令访问端口,不需要专门的 I/O 指令。题目要求选错误项,所以选 D。独立编址可以数值重合,统一编址则要求映射到不同的地址范围,不能把“共用地址空间”误理解成“不能访存”。

进入练习

第 22 题

计算机组成原理
2 分

若某设备中断请求的响应和处理时间为 100ns,每 400ns 发出一次中断请求,中断响应所允许的最长延迟时间为 50ns,则在该设备持续工作过程中,CPU 用于该设备的 I/O 时间占整个 CPU 时间的百分比至少是()。

A. 12.5%12.5\%

B. 25%25\%

C. 37.5%37.5\%

D. 50%50\%

查看答案与解析收起答案与解析

参考答案:B

答案:B。

每 400 ns 发出一次请求,而一次中断响应与处理占用 CPU 100 ns。在设备连续工作并及时处理每次请求时,一个 400 ns 周期至少有 100 ns 用于该设备,所以比例为 100/400=25%100/400=25\%,选 B。

50 ns 是请求提出后允许等待开始响应的最长时间,是实时性约束;在这段等待中 CPU 可执行其他程序,不是本设备额外消耗的服务时间,不能直接加到分子。A 的 12.5% 把 50 ns 当服务时间,C 的 37.5% 算了 (100+50)/400(100+50)/400,D 的 50% 也多算开销。已经给出的 100 ns 包含响应和处理,不能把二者再拆开重复加一次。

进入练习

第 23 题

操作系统
2 分

下列调度算法中, 不可能导致饥饿现象的是 ( )。

A. 时间片轮转

B. 静态优先数调度

C. 非抢占式短作业优先

D. 抢占式短作业优先

查看答案与解析收起答案与解析

参考答案:A

答案:A。

饥饿指进程一直具备运行条件,却因调度偏好长期得不到 CPU。时间片轮转把就绪进程放入队列,每次运行有限时间片,未完成者排回队尾;新的进程按队列规则加入,等待者会依次轮到,不会被不断插来的优先任务无限越过,故 A 不导致饥饿。

B 静态优先数若持续有高优先级进程就绪,低优先级者可能永远等待。C 非抢占短作业优先在每次选择下一作业时都偏向短作业,持续短作业会饿死长作业;D 抢占短作业优先还可让不断到来的短任务反复抢占长任务,也可能饥饿。非抢占只表示已经获得 CPU 后不会被强夺,不保证此前等待一定有界。

进入练习

第 24 题

操作系统
2 分

某系统有 nn 台互斥使用的同类设备, 三个并发进程分别需要 3、4、5 台设备, 可确保系统不发生死锁的设备数 nn 最小为 ( )。

A. 9

B. 10

C. 11

D. 12

查看答案与解析收起答案与解析

参考答案:B

答案:B。

同类设备互斥使用,最坏情况是每个进程均持有“最大需求减 1”台,仍各等一台。三个进程可分别占 2、3、4 台,共 2+3+4=92+3+4=9 台;若总数为 9,设备全被占用且无人能完成释放,存在死锁,故 A 不够。

若有 10 台,在所有进程都尚未取得全部需求时,它们合计最多持有 9 台,至少还剩 1 台;把它给某个等待者,至少一个进程能满足最大需求并完成释放。随后剩余两进程的需求也可逐步满足。通用下限为 1+∑(ri−1)=101+\sum(r_i-1)=10,选 B。C 的 11 和 D 的 12 都足够,却不是最少;12 是总最大需求,防死锁不要求三者同时取得全部设备。

进入练习

第 25 题

操作系统
2 分

下列指令中,不能在用户态执行的是()。

A. trap 指令

B. 跳转指令

C. 压栈指令

D. 关中断指令

查看答案与解析收起答案与解析

参考答案:D

答案:D。

特权指令会改变系统全局控制或硬件保护状态,只允许内核执行。关中断会使处理器停止响应相应中断,若用户程序可随意执行,可能影响时钟调度、I/O 服务和其他进程运行,因此 D 只能在内核态执行。

A trap 是用户程序请求内核服务的合法入口,可在用户态执行,并由硬件转入受保护的内核处理程序;“执行后进入内核”不等于“只能在内核执行”。B 普通跳转改变本进程控制流,C 压栈操作在权限允许的用户栈上写数据,均允许用户态使用。若跳转或栈地址非法会触发异常,但这并不把普通跳转、压栈指令本身变成特权指令。

进入练习

第 26 题

操作系统
2 分

一个进程的读磁盘操作完成后,操作系统针对该进程必做的是()。

A. 修改进程状态为就绪态

B. 降低进程优先级

C. 为进程分配用户内存空间

D. 增加进程的时间片大小

查看答案与解析收起答案与解析

参考答案:A

答案:A。

按题目通常的同步读磁盘模型,进程提出请求后要等数据,状态由运行转为阻塞。磁盘操作完成使它等待的事件满足,内核将其唤醒、移入就绪队列,并把状态改为就绪,故 A 是必做步骤。

进程不会必然立即成为运行态,因为 CPU 可能还在执行其他进程,需要调度器选择后才运行。B 降低优先级与 D 增加时间片取决于具体调度策略,I/O 完成并不要求这样做;C 用户内存空间通常在创建或请求阶段已安排,完成一次读操作不意味着必需重新分配。题意对应等待本次 I/O 的阻塞进程;不能把一般异步 I/O 下仍在运行的其他模型混入这一状态转换判断。

进入练习

第 27 题

操作系统
2 分

现有一个容量为 10GB 的磁盘分区, 磁盘空间以簇为单位进行分配, 簇的大小为 4 KB4 \mathrm{~KB} , 若采用位图法管理该分区的空闲空间, 即用一位 (bit) 标识一个簇是否被分配, 则存放该位图所需的簇数为 ( )。

A. 80

B. 320

C. 80 K80 \mathrm{~K}

D. 320K

查看答案与解析收起答案与解析

参考答案:A

答案:A。

位图每一位代表一个簇,先算磁盘有多少簇,再把位图的 bit 换算成字节,最后除以每簇容量。本题存储容量按二进制计,10 GB=10×23010\times2^{30} B,4 KB=2122^{12} B。

簇数 N=10×230/212=10×218N=10\times2^{30}/2^{12}=10\times2^{18};位图需 N bit,即 N/8=10×215=327680N/8=10\times2^{15}=327680 B=320 KB;这些字节占 327680/4096=80327680/4096=80 簇,选 A。B 的 320 是位图的 KB 数,不是簇数;C、D 还多了 K 的数量级。这里结果恰为整数,一般位图字节数和存放簇数都要向上取整,不能将不足一簇的部分舍弃。

进入练习

第 28 题

操作系统
2 分

下列措施中,能加快虚实地址转换的是()。

I. 增大快表(TLB)容量

II. 让页表常驻内存

III. 增大交换区(swap)

A. 仅I

B. 仅 II

C. 仅I、II

D. 仅 II、III

查看答案与解析收起答案与解析

参考答案:C

答案:C。

虚实地址转换要由虚页号查到物理页框号,TLB 缓存近期页表项。I 增大 TLB 容量,通常能保留更多有效映射、提高命中率,减少访问慢页表的机会,从而加快平均转换速度。

II 让页表常驻内存,避免查某个页表项时因页表本身不驻留而访问外存,也有助于快速转换。III 增大 swap 只是提供更多外存交换空间,影响能存放多少换出页面,不缩短 TLB 查询或页表访问时间。因此 I、II 正确,选 C;A、B 都只列一项,D 错含 III 且漏 I。TLB 容量不决定物理内存是否足够,也不能把增加交换区等同于提高存储器速度。

进入练习

第 29 题

操作系统
2 分

在一个文件被用户进程首次打开的过程中,操作系统需要做的是()。

A. 将文件内容读到内存中

B. 将文件控制块读到内存中

C. 修改文件控制块中的读写权限

D. 将文件的数据缓冲区首指针返回给用户进程

查看答案与解析收起答案与解析

参考答案:B

答案:B。

打开文件是为后续 read、write 建立访问上下文,尚不是读取全部内容。首次打开时,操作系统按路径找到文件的目录信息,把文件控制块或索引节点读入内存,检查权限并建立系统及进程打开表项,因此 B 正确。

A 整个文件内容不必立即读入,真正的数据通常在读取调用时按需装入缓冲;大型文件也不能总是一次装入。C 打开要检查既有权限,不会因打开就修改权限。D 通常返回文件描述符或句柄,指向受控的打开记录,不把内核数据缓冲区首地址直接交给用户进程。应区分文件元数据、打开表项及文件实际数据,三者用途不同。

进入练习

第 30 题

操作系统
2 分

在页式虚拟存储管理系统中,采用某些页面置换算法,会出现 Belady 异常现象,即进程的缺页次数会随着分配给该进程的页框个数的增加而增加。下列算法中,可能出现 Belady 异常现象的是()。

I. LRU 算法

II. FIFO算法

III. OPT 算法

A. 仅II

B. 仅 I、II

C. 仅 I、III

D. 仅II、III

查看答案与解析收起答案与解析

参考答案:A

答案:A。

Belady 异常是增加页框反而增加缺页次数,发生原因是更多页框改变了置换轨迹,并未保证原来保留的页面仍被保留。FIFO 只按进入内存的时间淘汰,可能出现这种情况。例如引用串 1、2、3、4、1、2、5、1、2、3、4、5,用 FIFO 时 3 个页框缺页 9 次,4 个页框缺页 10 次,故 II 可能。

I LRU 按最近使用次序保留页面,具有栈性质:同一引用过程下,m 页框驻留集合包含于 m+1 页框集合,所以不会因增加页框多缺页。III OPT 选择将来最晚使用的页,也具有这一性质。只有 II,选 A;B、C 错含 I,D 错含 III。不能凭“页框更多通常更好”就否认异常定义。

进入练习

第 31 题

操作系统
2 分

下列关于管道(Pipe)通信的叙述中,正确的是()。

A. 一个管道可实现双向数据传输

B. 管道的容量仅受磁盘容量大小限制

C. 进程对管道进行读操作和写操作都可能被阻塞

D. 一个管道只能有一个读进程或一个写进程对其操作

查看答案与解析收起答案与解析

参考答案:C

答案:C。

管道是由内核管理的有限缓冲字节流。按通常阻塞式管道语义,管道为空且还有写端存在时,读者等数据而阻塞;管道已满时,写者等空位也可阻塞,所以 C 正确。写端全部关闭时空管道读到的是结束标志,这与等待数据的情况应区分。

A 普通管道是单向通信,双向交流通常需要两个管道。B 管道缓冲主要在内存,由内核容量限制,不是只受磁盘容量限制。D 管道可供多个读进程或多个写进程共享,但它们可能竞争字节流,应自行遵守并发协议,不是结构上只能有一个。是否阻塞还与非阻塞选项有关,本题问“可能”,通常阻塞方式已能说明。

进入练习

第 32 题

操作系统
2 分

下列选项中,属于多级页表优点的是()。

A. 加快地址变换速度

B. 减少缺页中断次数

C. 减少页表项所占字节数

D. 减少页表所占的连续内存空间

查看答案与解析收起答案与解析

参考答案:D

答案:D。

一级页表按完整虚拟页号建立大表,可能需要很大的一段连续内存。多级页表把它拆成页目录和多个较小的页表页,各部分可以放在分散的物理页框中,未使用的虚拟地址范围还可不建立下级表。因此 D 减少页表所占的连续内存空间是其优点。

A 不对,多级查表通常要逐层访存,TLB 未命中时反而可能更慢;B 程序页面的缺页由访问局部性、页框数、置换策略等决定,多级页表不直接减少它;C 每个页表项需要的映射、状态字段不因层级增加必然缩小,多级目录还可能增加额外项。减少连续空间要求不等于每个表项更小,也不等于所有情况下总页表字节数必定下降。

进入练习

第 33 题

计算机网络
2 分

在 OSI 参考模型中, 直接为会话层提供服务的是 ( )。

A. 应用层

B. 表示层

C. 传输层

D. 网络层

查看答案与解析收起答案与解析

参考答案:C

答案:C。

OSI 中每一层直接向紧邻的上一层提供服务,并使用紧邻下一层的服务。自上而下为应用、表示、会话、传输、网络、数据链路、物理,因此会话层的下一层是传输层,C 正确。

A 应用层位于会话层上方且隔着表示层,不是直接为会话层提供服务的下层。B 表示层直接使用会话层服务,服务方向正好相反。D 网络层向传输层提供服务,与会话层之间隔着传输层。理解“为谁提供服务”时先确定上下关系,再看是否直接相邻;不能只因为两层都参与端到端通信就认为没有中间层。

进入练习

第 34 题

计算机网络
2 分

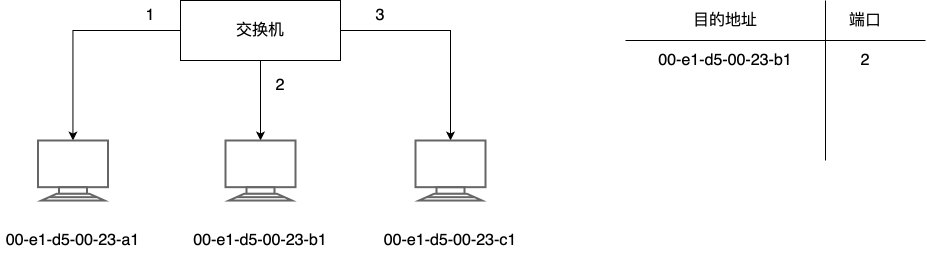
某以太网拓扑及交换机当前转发表如下图所示,主机 00-e1-d5-00-23-a1 向主机 00-e1-d5-00-23-c1 发送 1 个数据帧,主机 00-e1-d5-00-23-c1 收到该帧后,向主机 00-e1-d5-00-23-a1 发送 1 个确认帧,交换机对这两个帧的转发端口分别是()。

第 34 题图 1
目的地址 端口
00-e1-d5-00-23-b1 2

A. {3}\{3\} 和 {1}\{1\}

B. {2,3}\{2,3\} 和 {1}\{1\}

C. {2,3}\{2,3\} 和 {1,2}\{1,2\}

D. {1,2,3}\{1,2,3\} 和 {1}\{1\}

查看答案与解析收起答案与解析

参考答案:B

答案:B。

交换机根据源 MAC 学习“地址→入端口”,根据目的 MAC 查表转发。图中 a1、b1、c1 分别接端口 1、2、3,初始表仅有 b1→2。a1 发往 c1 的帧由端口 1 到达,交换机先学习 a1→1,再查目的 c1;因 c1 未知,向除入端口外所有端口泛洪,即 {2,3}。

c1 的确认帧由端口 3 到达,交换机学习 c1→3;此时目的 a1 已在表中,定向发到 {1}。故选 B。A 误以为第一帧已知道 c1;C 忽略第一帧对 a1 的学习,使回复也泛洪;D 把入端口 1 也列入第一帧泛洪集合。学习源地址与查询目的地址发生在同次接收处理中,不能只用初始表判断第二帧。

进入练习

第 35 题

计算机网络
2 分

下列因素中,不会影响信道数据传输速率的是()。

A. 信噪比

B. 频率带宽

C. 调制速率

D. 信号传播速度

查看答案与解析收起答案与解析

参考答案:D

答案:D。

数据传输速率表示每秒注入信道多少 bit,信号传播速度表示信号沿介质每秒走多远,二者单位与含义不同。D 的传播速度决定一定距离上的传播时延 t=d/vt=d/v,不会直接决定信道每秒能编码传输多少数据,故选 D。

A 信噪比影响有噪信道的容量,香农公式为 C=Blog⁡2(1+S/N)C=B\log_2(1+S/N);B 频率带宽 B 也出现在该式,限制速率。C 调制速率是每秒码元数,若每码元携带 b bit,则比特率为“码元率×b”,当然影响传输速率。链路有很长传播时延仍可有很高比特率;传播速度可能影响协议窗口等吞吐表现,但不是本题所问的信道数据率参数。

进入练习

第 36 题

计算机网络
2 分

主机甲与主机乙之间使用后退 NN 帧协议(GBN)传输数据,甲的发送窗口尺寸为 1000,数据帧长为 1000 字节,信道带宽为 100Mbps,乙每收到一个数据帧立即利用一个短帧(忽略其传输延迟)进行确认,若甲、乙之间的单向传播延迟是 50ms,则甲可以达到的最大平均数据传输速率约为()。

A. 10Mbps

B. 20Mbps

C. 80Mbps

D. 100Mbps

查看答案与解析收起答案与解析

参考答案:C

答案:C。

GBN 发送窗口限制尚未确认的帧数,窗口未滑动前最多发 1000 帧。每帧 1000 B=8000 bit,在 100 Mbps 链路上发送需 8000/108=80 μs=0.08 ms8000/10^8=80\,\mu\mathrm s=0.08\,\mathrm{ms}。第一个确认返回需该帧发送时间加双向传播,即 0.08+2×50=100.08 ms0.08+2\times50=100.08\,\mathrm{ms}。

窗口可覆盖 1000×8000=8×1061000\times8000=8\times10^6 bit,故平均数据率受限于 8×10⁶/0.10008≈79.94 Mbps8\times10^6/0.10008\approx79.94\,\mathrm{Mbps},约 80 Mbps,选 C。连续发完窗口只需 80 ms,确认还未返回,确有等待,因此 D 的 100 Mbps 达不到;A、B 低估了窗口可覆盖数据量。确认帧的发送延迟已被题设忽略,传播时延仍要算往返。

进入练习

第 37 题

计算机网络
2 分

站点 A、B、C 通过 CDMA 共享链路,A、B、C 的码片序列分别是 (1,1,1,1)(1, 1, 1, 1) , (1,−1,1,−1)(1, -1, 1, -1) 和 (1,1,−1,−1)(1, 1, -1, -1) 。若 C 从链路上收到的序列是 (2,0,2,0,0,−2,0,−2,0,2,0,2)(2, 0, 2, 0, 0, -2, 0, -2, 0, 2, 0, 2) ,则 C 收到 A 发送的数据是()。

A. 000

B. 101

C. 110

D. 111

查看答案与解析收起答案与解析

参考答案:B

答案:B。

CDMA 的正交码片可让接收端从叠加信号中分离特定站的数据。要解 A 的数据,应与 A 的码片 (1,1,1,1) 做内积并除码长 4,而不是因为接收站是 C 就使用 C 的码。正交的其他站信号内积为 0,不影响理想解码结果。

将收到的 12 个码片分成三组:(2,0,2,0)(2,0,2,0) 得 (2+0+2+0)/4=+1(2+0+2+0)/4=+1;(0,−2,0,−2)(0,-2,0,-2) 得 −4/4=−1-4/4=-1;(0,2,0,2)(0,2,0,2) 得 4/4=+14/4=+1。按正码表示 1、负码表示 0,结果为 101,选 B。A 将全部判 0,C 将第二、三位颠倒,D 忽略中间负相关值,均不符逐组运算。零相关才代表该站该时段未发送。

进入练习

第 38 题

计算机网络
2 分

主机甲和主机乙已建立了 TCP 连接,甲始终以 MSS = 1KB 大小的段发送数据,并一直有数据发送;乙每收到一个数据段都会发出一个接收窗口为 10KB 的确认段。若甲在 t 时刻发生超时时拥塞窗口为 8KB,则从 t 时刻起,不再发生超时的情况下,经过 10 个 RTT 后,甲的发送窗口是()。

A. 10KB{10}\mathrm{{KB}}

B. 12KB12\mathrm{KB}

C. 14KB{14}\mathrm{{KB}}

D. 15 KB15 \mathrm{~KB}

查看答案与解析收起答案与解析

参考答案:A

答案:A。

TCP 实际发送窗口由拥塞控制与接收方流量控制共同限制,取 min⁡(cwnd,rwnd)\min(cwnd,rwnd)。发生超时前 cwnd=8 KB,超时后阈值 ssthresh=8/2=4ssthresh=8/2=4 KB,cwnd 重置为 1 MSS=1 KB,重新慢开始。

按题目常用每 RTT 更新模型,1、2 个 RTT 后 cwnd 为 2、4 KB;达到阈值后进入拥塞避免,每 RTT 约增 1 KB,随后为 5、6、7、8、9、10 KB,8 RTT 时已达 10 KB。之后即使 cwnd 继续增长,乙始终通告 rwnd=10 KB,实际发送窗口也不会超过 10 KB,因此经过 10 RTT 后选 A。B、C、D 均大于接收窗口上限;只计算拥塞窗口而漏掉 rwnd 会误选。

进入练习

第 39 题

计算机网络
2 分

下列关于 UDP 协议的叙述中,正确的是()。

I. 提供无连接服务

II. 提供复用/分用服务

III. 通过差错校验,保障可靠数据传输

A. 仅I

B. 仅 I、II

C. 仅II、III

D. I、II、III

查看答案与解析收起答案与解析

参考答案:B

答案:B。

I 正确:UDP 发送前无需建立连接,每个数据报独立提交。II 正确:发送端利用端口等信息让多个应用共用网络服务,接收端依据目的端口把报文交给相应应用,提供复用与分用。

III 错:UDP 校验和用于检测传输差错,但发现错误后丢弃不等于保证可靠交付;UDP 本身没有确认、超时重传、顺序恢复等机制,不能确保不丢失、不重复或按序到达。因此只有 I、II,选 B。A 漏掉端口复用/分用,C、D 均错含 III。应用可以在 UDP 上自行增加可靠机制,但那是应用协议的功能,不使 UDP 本身成为可靠运输协议。

进入练习

第 40 题

计算机网络
2 分

使用浏览器访问某大学 Web 网站主页时,不可能使用到的协议是()。

A. PPP

B. ARP

C. UDP

D. SMTP

查看答案与解析收起答案与解析

参考答案:D

答案:D。

浏览器访问 Web 主页不只使用应用层的 HTTP,还可能涉及域名解析、局域网地址解析和接入链路。A PPP 可用于点对点接入链路,承载网络分组;B ARP 可在 IPv4 以太网中解析同网段目标或网关的 MAC 地址;C UDP 可承载 DNS 查询,把大学网站域名解析成 IP,因此三者都可能使用。

D SMTP 负责邮件提交和服务器间邮件转送,获取 Web 主页不属于其职责,故不可能作为该访问过程所需协议,选 D。题目不要求每种接入方式必用 A、B、C,只需存在可能情形即可;不能因为网页正文通常由 HTTP/TCP 传送,就忽略辅助 DNS 的 UDP。打开邮件网站的页面也仍用 Web 协议,不等于浏览器在此请求中使用 SMTP。

进入练习

解答题

7 题 · 共 70 分

第 41 题

数据结构
13 分

二叉树的带权路径长度(WPL)是二叉树中所有叶结点的带权路径长度之和。给定一棵二叉树 TT ,采用二叉链表存储,结点结构如下:

left weight right

其中叶结点的 weight 域保存该结点的非负权值。设 root 为指向 T 的根结点的指针,请设计求 T 的 WPL 的算法,要求:

1)给出算法的基本设计思想。

  1. 使用 C 或 C++ 语言,给出二叉树结点的数据类型定义。

  2. 根据设计思想,采用 C 或 C++ 语言描述算法,关键之处给出注释。

查看答案与解析收起答案与解析

**(1)设计思想。**根到叶的路径长度按边数计,根深度为 0,每向孩子走一步深度加 1。WPL 只累计叶结点的“权值×深度”,内部结点的 weight 域不参与计算。深度优先遍历时把当前深度作为参数传下去:空子树返回 0;叶结点返回自己的带权长度;非叶返回左右子树贡献之和。

例如根的两个孩子都是叶,权分别为 2、3,它们深度都为 1,WPL=2×1+3×1=5;若其中一个叶移到深度 2,就需要把该叶对应乘数改为 2。判叶必须左右指针都为空,只为空一个表示仍有子树。

(2)结点类型与(3)C 算法。

c 复制代码
typedef struct Node {
    struct Node *left;
    int weight;
    struct Node *right;
} Node;

long long wpl_dfs(const Node *root, int depth) {
    if (root == 0) return 0;   // 空子树没有叶结点贡献
    if (root->left == 0 && root->right == 0)
        return (long long)root->weight * depth; // 只累计叶,先提升类型
    return wpl_dfs(root->left, depth + 1)
         + wpl_dfs(root->right, depth + 1);
}

long long wpl(const Node *root) {
    return wpl_dfs(root, 0);   // 根的路径长度为0
}

**正确性与复杂度。**叶结点直接按定义返回正确值,非叶的所有叶分属左右子树,递归得到两部分和再相加,既不遗漏也不重复;传入 depth+1 保证每个叶使用正确边数。每个结点访问一次,时间 O(n)O(n);递归同时保留的调用数不超过树高 h,额外空间 O(h)O(h),退化为链时可达 O(n)O(n)。空树 WPL=0;只有根一个叶时深度为 0,WPL 也为 0。用 long long 减少权值乘深度及累计求和的整数范围限制,假定结果在该类型可表示范围内。

进入练习

第 42 题

数据结构
10 分

某网络中的路由器运行OSPF路由协议,题42表是路由器R1维护的主要链路状态信息(LSI),题42图是根据题42表及R1的接口名构造出来的网络拓扑。

题 42 表 R1 所维护的 LSI

字段 R1 的 LSI R2 的 LSI R3 的 LSI R4 的 LSI
Router ID 10.1.1.1 10.1.1.2 10.1.1.5 10.1.1.6
Link1:邻接 ID 10.1.1.2 10.1.1.1 10.1.1.6 10.1.1.5
Link1:本地 IP 10.1.1.1 10.1.1.2 10.1.1.5 10.1.1.6
Link1:Metric 3 3 6 6
Link2:邻接 ID 10.1.1.5 10.1.1.6 10.1.1.1 10.1.1.2
Link2:本地 IP 10.1.1.9 10.1.1.13 10.1.1.10 10.1.1.14
Link2:Metric 2 4 2 4
Net1:Prefix 192.1.1.0/24 192.1.6.0/24 192.1.5.0/24 192.1.7.0/24
Net1:Metric 1 1 1 1

Router ID 标识路由器;Link 的邻接 ID 标识对端路由器,本地 IP 为对应接口地址;Metric 为链路或直连子网的费用。

第 42 题图 1

题42图 R1构造的网络拓扑

请回答下列问题。

1)本题中的网络可抽象为数据结构中的哪种逻辑结构?

2)针对题 42 表中的内容,设计合理的链式存储结构,以保存题 42 表中的链路状态信息(LSI)。要求给出链式存储结构的数据类型定义,并画出对应题 42 表的链式存储结构示意图(示意图中可仅以 ID 标识结点)。

3)按照迪杰斯特拉(Dijkstra)算法的策略,依次给出 R1 到达题 42 图中子网 192.1.x.x 的最短路径及费用。

查看答案与解析收起答案与解析

**(1)逻辑结构。**网络可抽象为带权图,路由器和子网是顶点,连接关系是边,Metric 是非负边权。题表中双向链路费用相同,可按带权无向图理解;保存 LSI 时仍分别保留各路由器本地接口信息,因为一条链路两端的本地 IP 不同。图结构用于表示多对多连接,不能简单当作树,因为 R1、R2、R4、R3 构成环路。

**(2)链式结构。**采用邻接表的思路:路由器头结点形成链表,每个头结点指向该路由器的链路和直连子网记录链。记录类型 kind 区分邻接路由器与子网;路由器记录要保存邻接 ID、本地 IP、费用,子网记录要保存网络地址、前缀长度、费用。示例 C 定义:

c 复制代码
#include <stdint.h>

typedef struct LinkNode {
    int kind;                 // 0:路由器链路;1:直连子网
    uint32_t id;              // 邻接路由器 ID 或网络地址
    uint32_t local_ip;         // 本地接口地址
    unsigned prefix_len;      // 子网前缀长度
    int metric;
    struct LinkNode *next;
} LinkNode;

typedef struct RouterNode {
    uint32_t router_id;
    LinkNode *first;
    struct RouterNode *next;
} RouterNode;

下列每行是一个 RouterNode 的 first 邻接链;四个头结点另由 next 串成 R1→R2→R3→R4→NULL。方括号仅画 ID 或子网前缀,其余字段按题表存入。

text 复制代码
10.1.1.1 -> [10.1.1.2] -> [10.1.1.5] -> [192.1.1.0/24] -> NULL
10.1.1.2 -> [10.1.1.1] -> [10.1.1.6] -> [192.1.6.0/24] -> NULL
10.1.1.5 -> [10.1.1.6] -> [10.1.1.1] -> [192.1.5.0/24] -> NULL
10.1.1.6 -> [10.1.1.5] -> [10.1.1.2] -> [192.1.7.0/24] -> NULL

例如 R1 到 R3 的记录存邻接 ID=10.1.1.5、本地 IP=10.1.1.9、Metric=2;反向 R3 到 R1 记录存本地 IP=10.1.1.10,不能因费用对称就只保存一端 IP。R1 的子网记录为网络地址 192.1.1.0、prefix_len=24、Metric=1,local_ip 对该类记录不使用。邻接记录用 uint32_t 保存地址的 32 位值,不把点分十进制文本当成一个普通十进制数。

**(3)Dijkstra 推导。**从 R1 出发,每次选择尚未确定且暂定距离最小的顶点,再松弛邻边。先看路由器之间的距离:

已选路由器 到 R2 的暂定费用 到 R3 的暂定费用 到 R4 的暂定费用
R1 3 2 ∞
再选 R3(2) 3 2 2+6=8
再选 R2(3) 3 2 min(8,3+4)=7
再选 R4(7) 3 2 7

每个子网到其路由器的费用均为 1,将这一末段加上。按子网最短距离从小到大,结果依次为:

子网 最短路径 费用
192.1.1.0/24 R1 直接到达 1
192.1.5.0/24 R1→R3→子网 2+1=3
192.1.6.0/24 R1→R2→子网 3+1=4
192.1.7.0/24 R1→R2→R4→子网 3+4+1=8

到 192.1.7.0/24 经 R3→R4 的备选费用是 2+6+1=9,比经 R2 的 8 大,故不选。把子网也作为顶点一同执行 Dijkstra 会得到同样结果,距离相同顶点的选取先后不影响上述最短费用。

进入练习

第 43 题

计算机网络
9 分

某网络中的路由器运行 OSPF 路由协议。R1 维护的主要链路状态信息(LSI)如下,网络拓扑及接口名称见配图。

字段 R1 的 LSI R2 的 LSI R3 的 LSI R4 的 LSI
Router ID 10.1.1.1 10.1.1.2 10.1.1.5 10.1.1.6
Link1:邻接 ID 10.1.1.2 10.1.1.1 10.1.1.6 10.1.1.5
Link1:本地 IP 10.1.1.1 10.1.1.2 10.1.1.5 10.1.1.6
Link1:Metric 3 3 6 6
Link2:邻接 ID 10.1.1.5 10.1.1.6 10.1.1.1 10.1.1.2
Link2:本地 IP 10.1.1.9 10.1.1.13 10.1.1.10 10.1.1.14
Link2:Metric 2 4 2 4
Net1:Prefix 192.1.1.0/24 192.1.6.0/24 192.1.5.0/24 192.1.7.0/24
Net1:Metric 1 1 1 1

Router ID 标识路由器;Link 的邻接 ID 标识对端路由器,本地 IP 为对应接口地址;Metric 为链路或直连子网的费用。

OSPF 网络的链路状态信息、拓扑与接口

请回答下列问题。

1)假设路由表结构如下表所示,请给出 R1 的路由表,要求包括到达图中子网 192.1.x.x 的路由,且路由表中的路由项尽可能少。

目的网络 下一跳 接口

2)当主机192.1.1.130向主机192.1.7.211发送一个 TTL=64\mathrm{TTL} = 64 的IP分组时,R1通过哪个接口转发该IP分组?主机192.1.7.211收到的IP分组TTL是多少?

3)若 R1 增加一条 Metric 为 10 的链路连接 Internet,则链路状态表中 R1 的 LSI 需要增加哪些信息?

路由表的字段格式
查看答案与解析收起答案与解析

**(1)先确定下一跳,再聚合。**R1 到 192.1.1.0/24 是 E0 直连;到 192.1.5.0/24 经 R3,下一跳应填 R3 面向 R1 的接口 10.1.1.10,而不是 R3 的 Router ID=10.1.1.5。到 192.1.6.0/24、192.1.7.0/24 的最短路都先经 R2,下一跳 10.1.1.2,输出 L0。

第三字节 6=00000110、7=00000111,共用前 7 位,两 /24 恰覆盖一个 /23,且下一跳和接口相同,所以合并为 192.1.6.0/23:

目的网络 下一跳 接口
192.1.1.0/24 直接交付 E0
192.1.6.0/23 10.1.1.2 L0
192.1.5.0/24 10.1.1.10 L1

三种转发方向分别为本地、R2、R3,不能只因地址接近就把不同出口的子网随意合并,故上述三项已尽可能少。/23 掩码为 255.255.254.0。

**(2)接口及 TTL。**目的 192.1.7.211 匹配 192.1.6.0/23,因此 R1 经 L0 发向 R2。最短路是 R1→R2→R4→目的主机:到 R4 费用 3+4=7,小于经 R3 的 2+6=8。IP TTL 每经过一个转发路由器减 1,分组经过 R1、R2、R4 共三台,接收 TTL=64-3=61。TTL 不是按链路 Metric 或经过的主机数减少。

**(3)Internet 出口。**在题目简化 LSI 模型中,为 R1 增加一个外网/默认目的条目,如 Net2 的 Prefix=0.0.0.0/0、Metric=10,表示未匹配更具体内部网络时可经该出口到达 Internet。/0 匹配所有地址,其他路由器可把到 R1 的费用再加 10,计算到出口的费用。题目未给新链路的对端 ID 和接口 IP,不能凭空指定这些地址。

进入练习

第 44 题

计算机组成原理
12 分

某程序中有如下循环代码段 P:for (int i = 0; i < N; i++) sum += A[i];。假设编译时变量 sum 和 i 分别分配在寄存器 R1 和 R2 中。常量 N 在寄存器 R6 中,数组 A 的首地址在寄存器 R3 中。程序段 P 起始地址为 0804 8100H,对应的汇编代码和机器代码如下表所示。

编号 地址 机器代码 汇编代码 注释
1 08048100H 00022080H loop: sll R4, R2, 2 (R2) << 2 → R4
2 08048104H 00832020H add R4, R4, R3 (R4) + (R3) → R4
3 08048108H 8C850000H load R5, 0(R4) ((R4) + 0) → R5
4 0804810CH 00250820H add R1, R1, R5 (R1) + (R5) → R1
5 08048110H 20420001H addi R2, R2, 1 (R2) + 1 → R2
6 08048114H 1446FFFAH bne R2, R6, loop if (R2) != (R6) goto loop

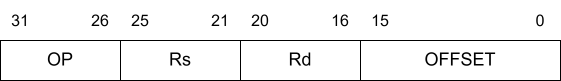
执行上述代码的计算机M采用32位定长指令字,其中分支指令bne采用如下格式:

字段 OP Rs Rd OFFSET
位号 31–26 25–21 20–16 15–0

OP为操作码;Rs和Rd为寄存器编号;OFFSET为偏移量,用补码表示。请回答下列问题,并说明理由。

1)M的存储器编址单位是什么?

2)已知 sll 指令实现左移功能,数组 A 中每个元素占多少位?

  1. 表中 bne 指令的 OFFSET 字段的值是多少?已知 bne 指令采用相对寻址方式,当前 PC 内容为 bne 指令地址,通过分析表中指令地址和 bne 指令内容,推断出 bne 指令的转移目标地址计算公式。

  2. 若 M 采用如下“按序发射、按序完成”的 5 级指令流水线: IF (取指)、ID (译码及取数)、EXE (执行)、MEM (访存)、WB (写回寄存器), 且硬件不采取任何转发措施, 分支指令的执行均引起 3 个时钟周期的阻塞, 则 P 中哪些指令的执行会由于数据相关而发生流水线阻塞? 哪条指令的执行会发生控制冒险? 为什么指令 1 的执行不会因为与指令 5 的数据相关而发生阻塞?

第 44 题图 1
查看答案与解析收起答案与解析

**(1)编址单位。**机器指令为 32 bit=4 B,表中相邻指令地址每次增加 4,说明每个地址代表 1 B,存储器按字节编址。若按一个 32 位字编址,相邻指令地址应增加 1。

**(2)数组元素大小。**R2 保存 i,指令 1 将它左移 2 位形成 4i4i,指令 2 再加数组基址,得到 A[i]A[i] 的地址。i 每增 1,元素地址增加 4 个字节,因此每元素 4 B=32 bit。移位表示地址步长,不是把元素值左移。

**(3)OFFSET 与目标公式。**bne 的机器码为 1446FFFAH,低 16 位 OFFSET=FFFAH,补码真值为 65530−65536=−665530-65536=-6。当前 PC=08048114H,目标 loop=08048100H,两者相差 -20 B;而下一条地址 PC+4=08048118H 与目标相差 -24 B,恰为 -6×4。因此目标地址公式是

Target=(PC)+4+4×signextend⁡(OFFSET).Target=(PC)+4+4\times\operatorname{signextend}(OFFSET).

代入 08048114H+4−24=08048100H08048114\mathrm H+4-24=08048100\mathrm H。偏移相对下一条指令计,并以 4 B 指令字为单位,不能直接用 PC+OFFSET。

**(4)流水线相关。**无转发时,后指令在 ID 读寄存器,必须等前指令 WB 写回。以下相邻指令存在先写后读的真实数据相关(RAW),即后指令需要读取前指令产生的结果,因此消费者必须等待:

被阻塞的指令 所需结果 生产该结果的指令
2:add R4,R4,R3 R4=4i 1
3:load R5,0(R4) R4=数组元素地址 2
4:add R1,R1,R5 R5=数组元素值 3
6:bne R2,R6,loop R2=自增后的 i 5

第 6 条还有控制冒险:是否跳转决定下一条应取 loop 还是顺序地址,按题设每次引入 3 个阻塞周期。下一轮第 1 条虽依赖上一轮第 5 条的 R2,但第 6 条等待 R2、再经历分支阻塞后,第 5 条早已写回,所以不新增数据阻塞。R1 的跨轮累加也有足够指令间隔,不能将所有寄存器依赖都视为必然暂停。

进入练习

第 45 题

计算机组成原理
10 分

某计算机 M 采用 32 位定长指令字和页式虚拟存储管理。程序段 P 为 for (int i = 0; i < N; i++) sum += A[i];。变量 sum 和 i 分别分配在寄存器 R1 和 R2 中,常量 N 在寄存器 R6 中,数组 A 的首地址在寄存器 R3 中。P 的起始地址为 08048100H,汇编代码和机器代码如下。

编号 地址 机器代码 汇编代码 注释
1 08048100H 00022080H loop: sll R4, R2, 2 (R2) << 2 → R4
2 08048104H 00832020H add R4, R4, R3 (R4) + (R3) → R4
3 08048108H 8C850000H load R5, 0(R4) ((R4) + 0) → R5
4 0804810CH 00250820H add R1, R1, R5 (R1) + (R5) → R1
5 08048110H 20420001H addi R2, R2, 1 (R2) + 1 → R2
6 08048114H 1446FFFAH bne R2, R6, loop if (R2) != (R6) goto loop

P 开始执行时,(R1)=(R2)=0(R1)=(R2)=0,(R6)=1000(R6)=1000。其机器代码已调入主存但不在 Cache 中;数组 A 未调入主存,且所有数组元素在同一页,并存储在磁盘同一个扇区。回答下列问题并说明理由。

1)P执行结束时,R2的内容是多少?

  1. M 的指令 Cache 和数据 Cache 分离。若指令 Cache 共有 16 行, Cache 和主存交换的块大小为 32 字节, 则其数据区的容量是多少? 若仅考虑程序段 P 的执行, 则指令 Cache 的命中率为多少?

  2. P 在执行过程中, 哪条指令的执行可能发生溢出异常? 哪条指令的执行可能产生缺页异常? 对于数组 A 的访问, 需要读磁盘和 TLB 至少各多少次?

查看答案与解析收起答案与解析

**(1)循环结束时的 R2。**R2 保存循环变量 i,初值为 0。每轮第 3 条读取 A[i],第 5 条将 i 加 1,第 6 条把自增后的 i 与 R6=1000 比较,不相等就跳回 loop。因此在程序正常执行结束时,R2=1000。最后一次读取的是 A[999],不是 A[1000],循环共执行 1000 轮。

**(2)指令 Cache 的容量与命中率。**Cache 有 16 行,每行的数据块为 32 B,所以数据区容量为 16×32=51216\times32=512 B。这里计算数据区,不包含标记、有效位等管理信息。

6 条指令各占 4 B,共 24 B。起始地址 08048100H 的低 5 位为 0,与 32 B 块边界对齐;程序占据 08048100H~08048117H,全部位于同一个主存块。第一次取第 1 条指令时发生一次 Cache 缺失,整个块调入指令 Cache,以后的取指都命中。指令 Cache 与数据 Cache 分离,数组数据不会把这个指令块置换掉;本题仅统计 P 的取指。

1000 轮共取指 6×1000=60006\times1000=6000 次,其中命中 5999 次,命中率为

59996000≈99.9833%≈99.98%.\frac{5999}{6000}\approx99.9833\%\approx99.98\%.

不能把每轮第 1 条指令都算成缺失,因为首次调入后该块已经驻留。

**(3)异常与数组访问计数。**第 4 条 add R1,R1,R5 实现 sum+=A[i],数组值与累加结果可能超出有符号 32 位整数范围,因此可能发生溢出异常。第 5 条只把 i 从 0 增到 1000,不会溢出;第 1、2 条按题目约定计算有效的数组地址,不把地址越界等题外情形引入计数。

第 3 条 load R5,0(R4) 是访问数组元素的指令。数组 A 起初不在主存,第一次访问会触发缺页;机器代码已在主存,取指不会因为程序页未调入而发生缺页。

题设全部数组元素在同一页、同一磁盘扇区。按最少次数计算,缺页时读入一次,之后该页不再被置换,所以至少读磁盘 1 次。虽然题设的数组大小与单扇区容量在实际设备上未必相符,本题直接采用给定的存储条件。

TLB 次数只统计数组 A 的地址转换,采用每次 load 查询一次 TLB、首次缺页处理后重试一次的计数约定。首次访问 A[0] 先查 TLB,发现其页不在主存并产生缺页;缺页处理调入页面并使转换映射可用后,重新执行这条 load,再查一次 TLB。其余 A[1]~A[999] 各查一次,故最少查询数为

2+999=1001.2+999=1001.

读取主存页表和回填 TLB 表项本身不另算 TLB 查询,取指的 TLB 查询也不计入“对于数组 A 的访问”。若采用另一种地址转换流程:缺页处理后首次重试仍先在 TLB 中未命中,随后查页表、回填映射,再独立查询 TLB,那么 A[0] 共查 3 次,总数为 3+999=10023+999=1002。这取决于缺页后的重试与回填流程;本题主答案统一按上述最少查询约定取 1001 次,使用其他流程时应说明计数边界。

进入练习

第 46 题

操作系统
7 分

文件 F 由 200 条记录组成,记录从 1 开始编号。用户打开文件后,欲将内存中的一条记录插入文件 F,作为其第 30 条记录。请回答下列问题,并说明理由。

  1. 若文件系统采用连续分配方式, 每个磁盘块存放一条记录, 文件 F 存储区域前后均有足够的空闲磁盘空间, 则完成上述插入操作最少需要访问多少次磁盘块? F 的文件控制块内容会发生哪些改变?

  2. 若文件系统采用链接分配方式, 每个磁盘块存放一条记录和一个链接指针, 则完成上述插入操作需要访问多少次磁盘块? 若每个存储块大小为 1KB1 \mathrm{KB} , 其中 4 字节存放链接指针,则该文件系统支持的文件最大长度是多少?

查看答案与解析收起答案与解析

**(1)连续分配。**插入新第 30 条意味着它前面保留原 1~29,后面是原 30~200。可选择向前搬前 29 条,或向后搬后 200−29=171200-29=171 条。文件区域两侧均有空位,应选移动较少的前 29 条。

设原首块为 b,将原记录 1 搬到 b-1,原记录 2 搬到 b,依次将原记录 29 搬到 b+27,从前往后移动避免覆盖未读记录;空出的 b+28 写新记录,原记录 30 位于 b+29,无需移动。每条搬运读、写各一次,需 29×2=5829\times2=58 次,加写入新记录 1 次,共 59 次数据块访问。FCB 的起始块号改为 b-1,文件长度/记录数增加一条,分配块数由 200 改为 201,尾块不变。这里不重复计已打开文件的元数据访问。

**(2)链接分配。**从首块沿链接读取第 1~29 块,共 29 次,得到第 29 块原来的下一块指针 p。分配新块,让新块存入新记录且 next=p,写新块 1 次;再将已读到内存的第 29 块的 next 改为新块地址,写回 1 次。因此共 29+1+1=3129+1+1=31 次,不用读取原第 30 块或搬动后续记录。

4 B 链接指针有 32 位,按题目的容量模型最多编号 2322^{32} 个块;每块 1 KB=1024 B,其中 4 B 为链接,有效数据 1020 B。最大文件数据长度为 1020×2321020\times2^{32} B=4080×2304080\times2^{30} B,即 4080 GiB。若按传统二进制口径写作 4080 GB,应理解此处 GB=2302^{30} B。该上限忽略元数据与特殊空指针保留,不能把指针的 4 B 也算作文件数据。

进入练习

第 47 题

操作系统
9 分

系统中有多个生产者和多个消费者进程,共享一个能存放 1000 件产品的环形缓冲区(初始为空)。当缓冲区未满时,生产者进程可以放入其生产的一件产品,否则等待;当缓冲区未空时,消费者进程可以从缓冲区取走一件产品,否则等待。要求一个消费者进程从缓冲区连续取出 10 件产品后,其他消费者进程才可以取产品。请使用信号量 P、V [wait() 和 signal()] 操作实现进程间的互斥与同步,要求写出完整的过程,并说明所用信号量的含义和初值。

查看答案与解析收起答案与解析

容量同步与批次互斥需要分别控制。empty=1000 表示空位置,full=0 表示已有产品,初始为空;bufferMutex=1 保护数组及 in、out 的单次修改;consumerMutex=1 只在消费者之间保护完整的“连续取 10 件”批次。in、out 初值均为 0,下标按模 1000 循环。

text 复制代码
semaphore empty = 1000, full = 0;
semaphore bufferMutex = 1, consumerMutex = 1;
int in = 0, out = 0;

生产者:
    while (true) {
        product = 生产一件产品;
        P(empty);
        P(bufferMutex);
        buffer[in] = product;
        in = (in + 1) % 1000;
        V(bufferMutex);
        V(full);
    }

消费者:
    while (true) {
        P(consumerMutex);
        for (int k = 0; k < 10; ++k) {
            P(full);
            P(bufferMutex);
            product = buffer[out];
            out = (out + 1) % 1000;
            V(bufferMutex);
            V(empty);
            消费 product;
        }
        V(consumerMutex);
    }

**同步与互斥理由。**生产者先 P(empty) 才能占空位,存入后 V(full) 通知有产品;消费者先 P(full) 才能取产品,取出后 V(empty) 通知空位。bufferMutex 保证多个生产者不会写同一位置,缓冲操作期间也不会互相破坏共享状态。consumerMutex 在整个十次循环外申请、释放,故其他消费者不能插入当前批次,但生产者不申请它,仍能持续补充产品。

若当前只有不足 10 件,消费者可先取已有产品,再等后续产品;等待期间已经释放 bufferMutex,所以生产者能写入,最终完成本批。若把 P(full) 放到 P(bufferMutex) 后,空缓冲时消费者会持有缓冲锁等待,而生产者又需要该锁放产品,形成死锁。因此所有资源数量等待必须在占缓冲操作锁之前。消费动作使用取出的私有 product,可在缓冲锁外进行;消费者批次锁仍保持到取满 10 件。

进入练习